
AI-ассистент для поиска и сравнения данных на сайте
Клиент
Об опыте разработки самого сайта читайте в отдельном кейсе
Задача
- Создать на сайте поиск, аналогичный Google/Yandex, но работающий исключительно по существующей базе данных сайта.
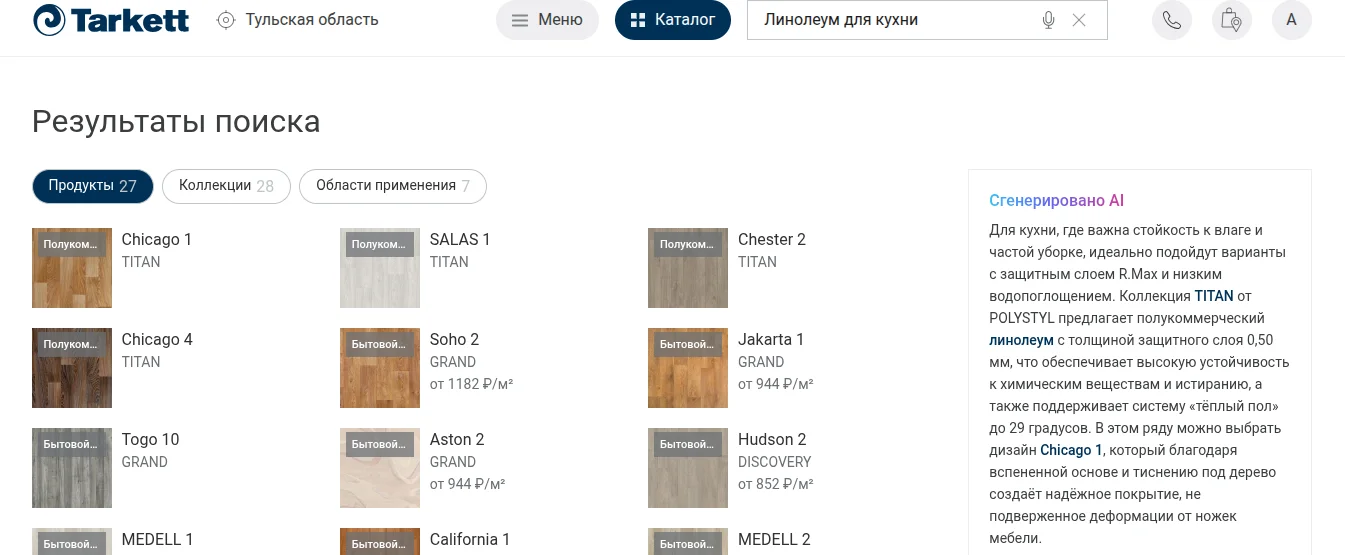
- Помимо канонического поиска - AI-ассистент, который показывает ответ модели на поисковый запрос. У пользователя должна быть возможность открыть ассистента на сайте и продолжить с ним общение.
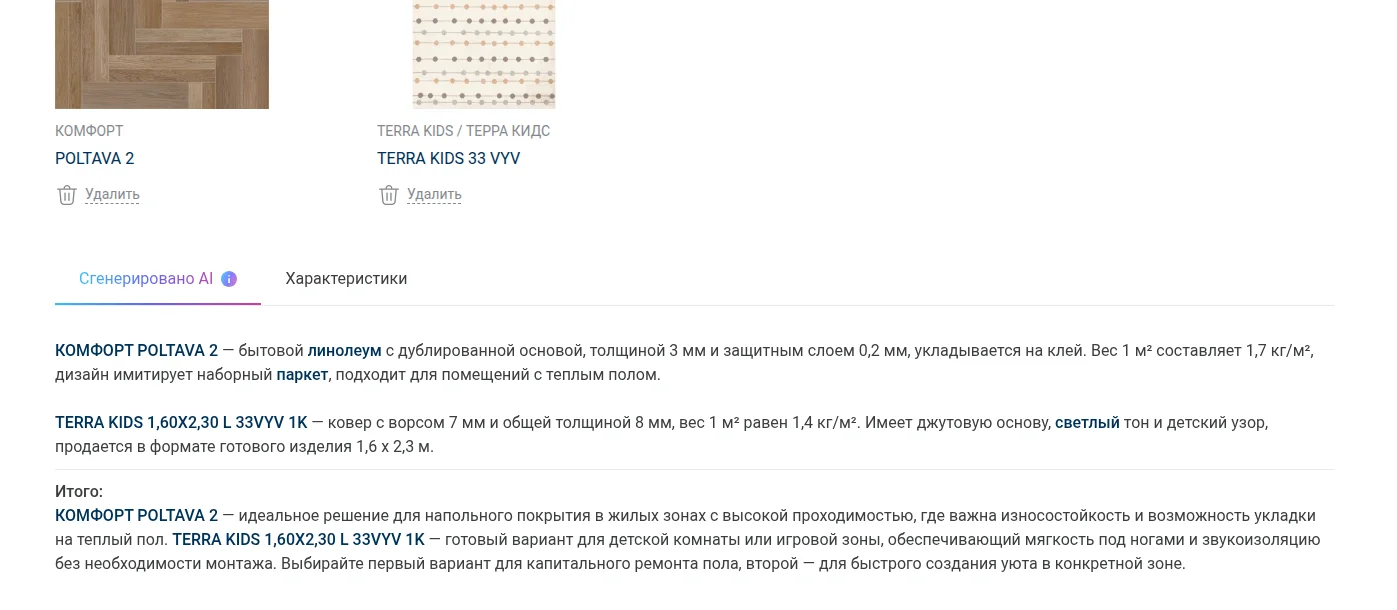
- Для продуктовой матрицы и классического сравнения продуктов по параметрам реализовать раздел сравнения продукции. Помимо таблицы параметров - AI-сравнение по каждому продукту, участвующему в сравнении: ответ может содержать текст или ссылки на графические и видеоматериалы сайта, примеры оформления интерьеров с конкретным продуктом (референсы) и так далее. Раздел также учитывает динамически обновляемый контент сайта - например каталоги продукции с характеристиками.
- Система должна быть отказоустойчивой и выдерживать нагрузку, присущую интернет-магазину, с контролируемым расходом ресурсов.
Решение
- Разработка архитектуры AI-ассистента.
- Прототипирование.
- Подготовка и создание векторных БД.
- Создание AI-ассистента для поиска: блок общения с ИИ-ассистентом.
- Создание AI-ассистента для сравнения продукции: AI-сравнение по каждому продукту, участвующему в сравнении.
- Вывод управления системой в административную панель.
Прототип: проверка концепции
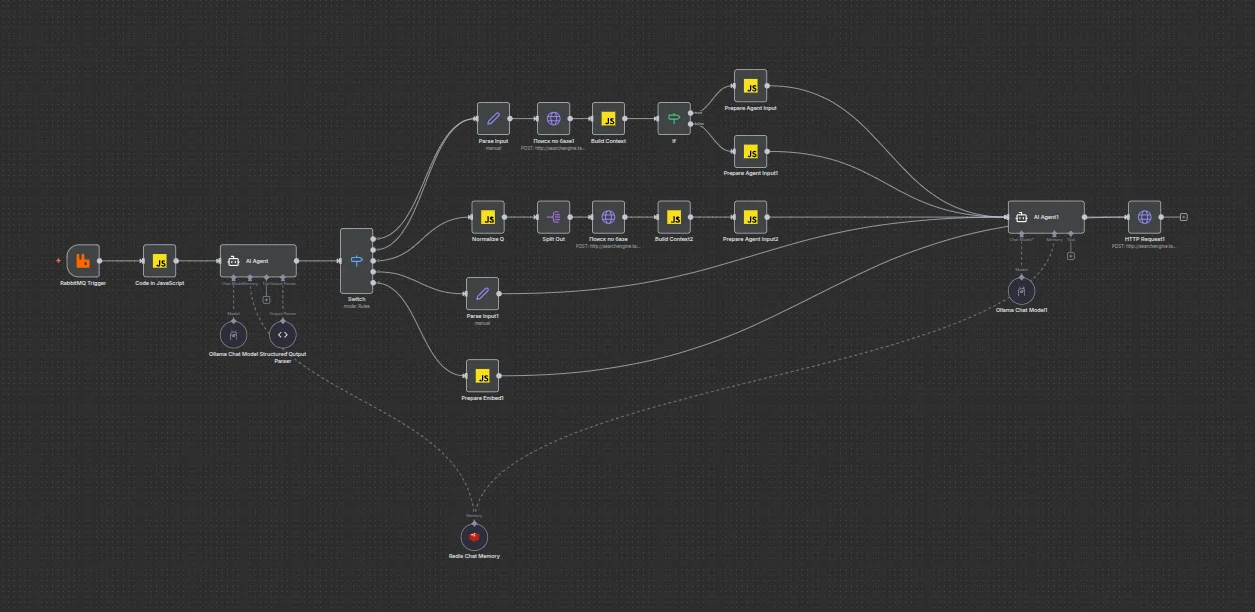
В прототипе реализовали всю основную логику будущего ассистента:
- Классический RAG-пайплайн. Выстроили конвейер: бот сначала ищет факты в базе знаний, потом генерирует ответ. Это отсекло проблему «галлюцинаций»: бот не выдумывал характеристики ламината, а опирался только на реальные данные из каталога.
- Сценарий сравнения N товаров. Система разбирает сложные запросы вроде «Сравни коллекцию X и Y», находит оба товара в базе и собирает для них единый структурированный контекст для нейросети.
- Умное кеширование. Бот не генерирует один и тот же ответ дважды. Это экономило вычислительные ресурсы и избавляло пользователя от лишнего ожидания.
Ещё на этапе no-code-прототипа мы четко определились со стеком для будущего продакшена. n8n - временная оболочка для проверки, поэтому сразу заложили, что «под капотом» итогового решения будут работать:
- Redis - кеши и история диалогов;
- RabbitMQ - очередь задач, чтобы сервер не падал при наплыве пользователей, а запросы корректно выстраивались;
- Qdrant - векторная база данных.
Это сэкономило массу времени при переходе на код: отлаженную бизнес-логику мы просто перенесли в продакшн, ничего не изобретая заново. n8n подошёл и для быстрой отладки промптов, и для наглядной демонстрации заказчику - клиент увидел живой работающий продукт, а не абстрактные схемы.
Как только концепция подтвердилась и логика отлажена, перешли на полноценную разработку на Python: полный контроль над данными, плавный стриминг ответа и все выбранные технологии в полную силу.
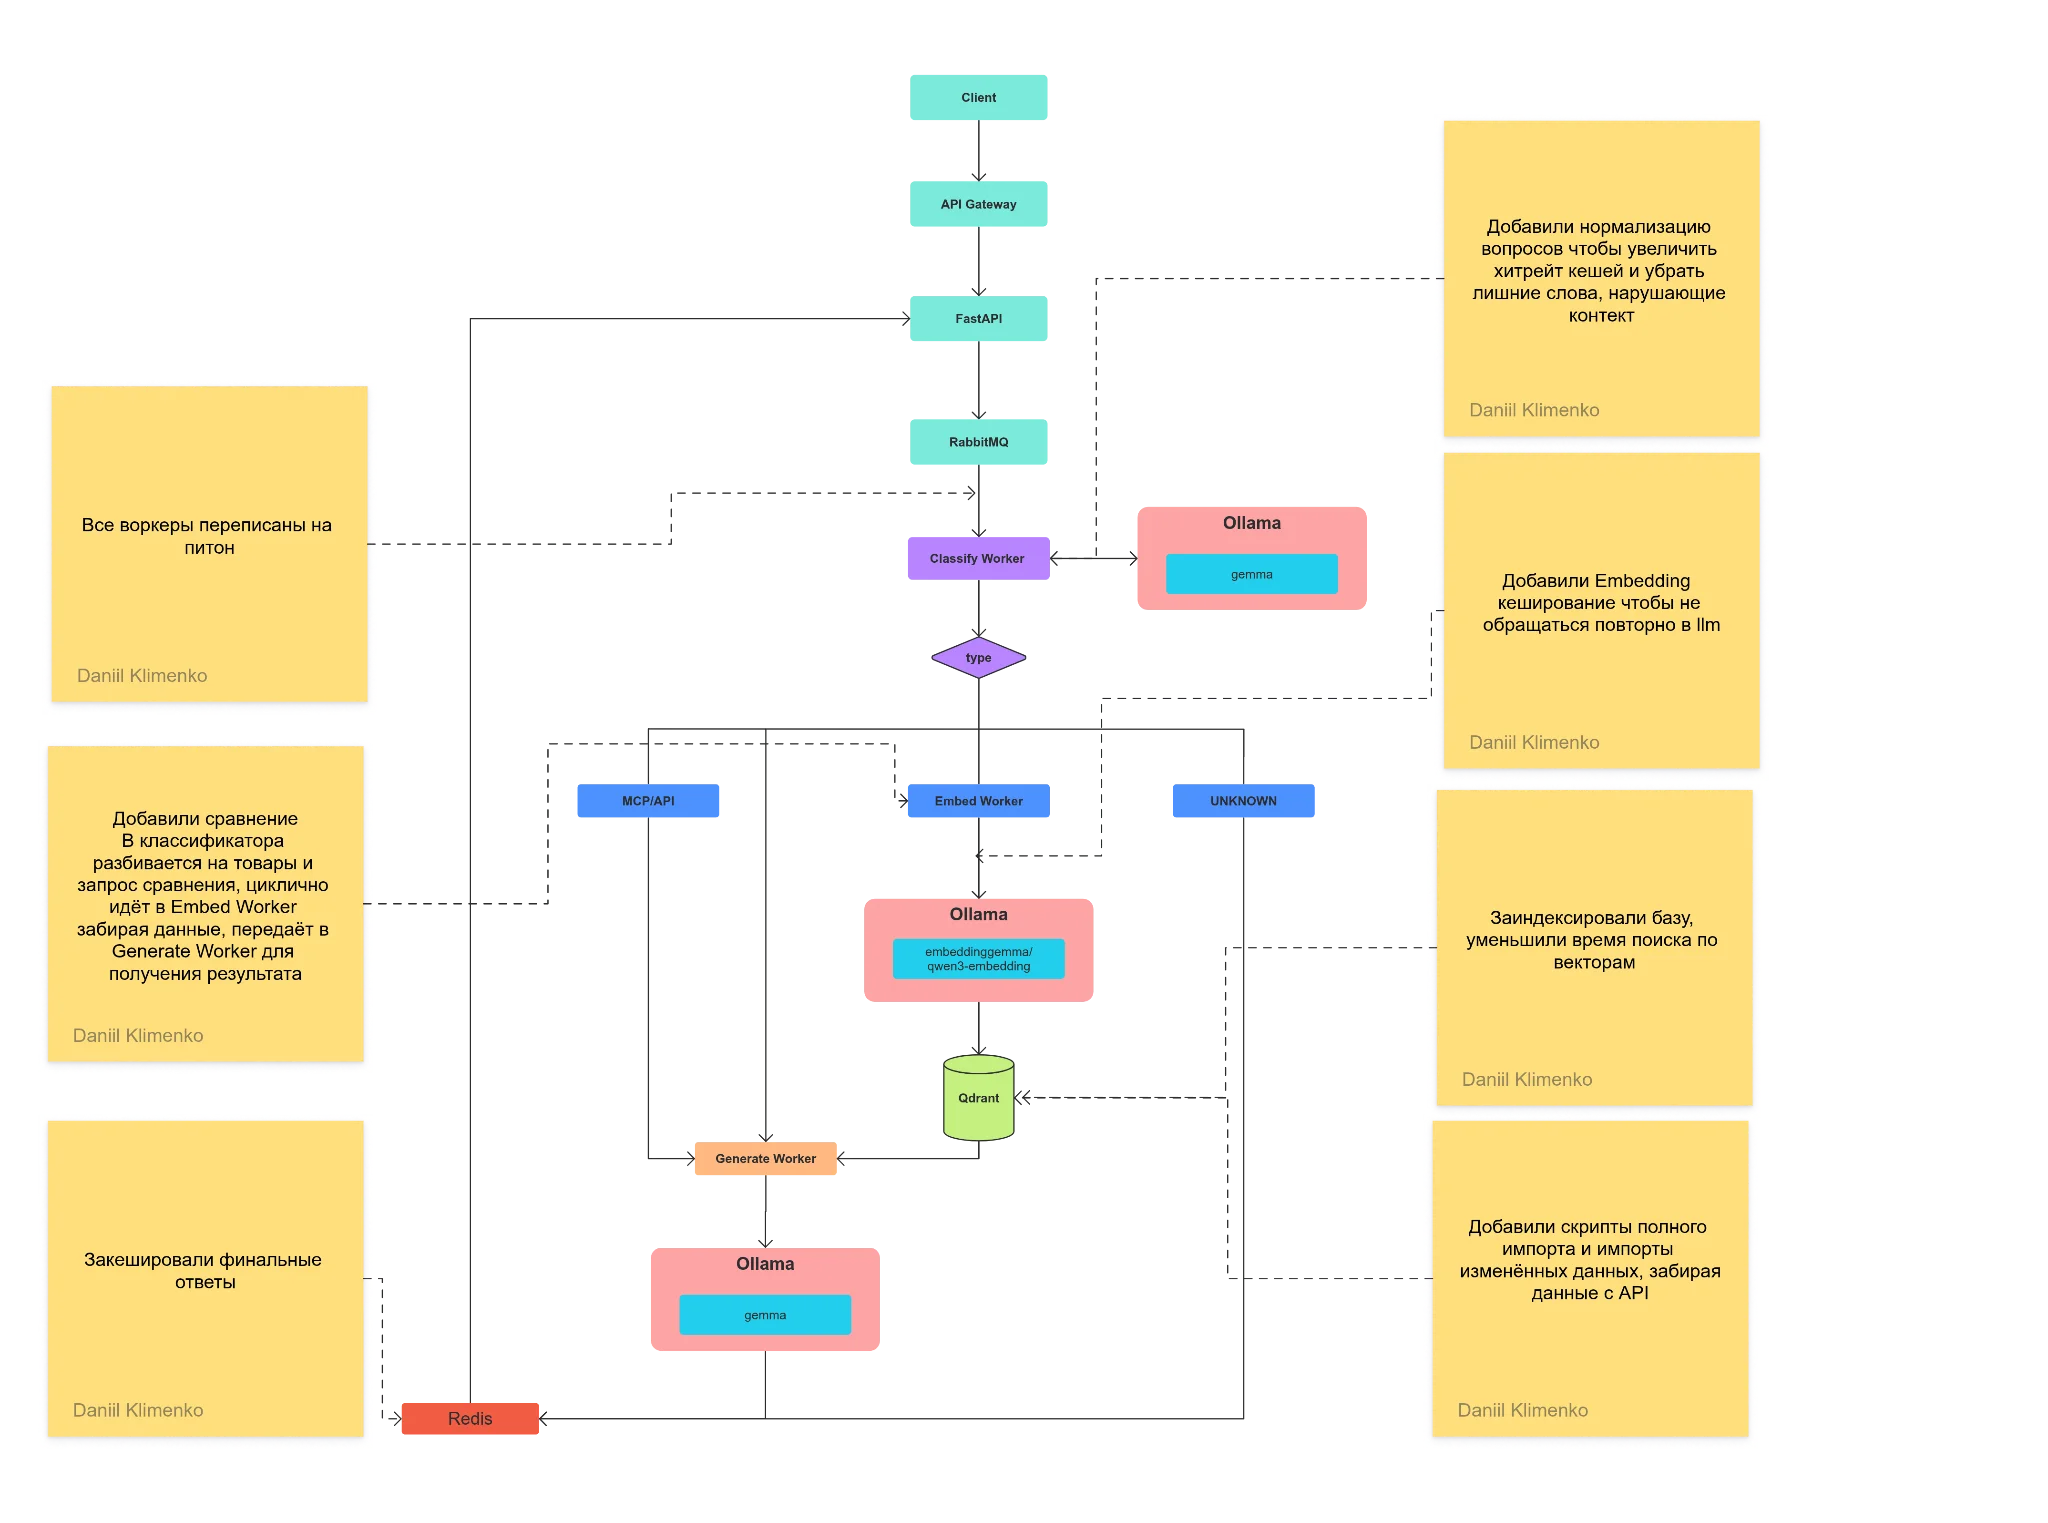
Как работает «мозг» ассистента
1. Нормализация, интент и маршрутизация
Пользователь может написать: «А ещё?» или «Подешевле?». Для человека это понятно, для машины - пустой звук.
Специальный модуль-классификатор смотрит на историю диалога и переписывает запрос в понятную для поиска форму: «Покажи ещё варианты напольных покрытий, как в предыдущем сообщении».
Система определяет интент (намерение): человек хочет конкретный товар, совет по выбору, инструкцию по укладке или сравнивает коллекции? От этого зависит, где именно мы будем искать ответ, и это позволяет увеличить хитрейт кеширования, сводя похожие запросы к единому ответу. Например, запросы «Коллекция Баллет» и «Коллекция Balet» сходятся к одному каноническому запросу - «коллекция BALLET».
На этом же этапе происходит умная маршрутизация. В зависимости от интента ассистент подгружает специализированный системный промпт: для подбора товара - один, для инструкции - другой, для сравнения - третий. Модель говорит на языке пользователя и не путается в контексте.
Если запрос не относится к продукции компании, система распознаёт оффтоп и вежливо отвечает заготовленным шаблоном: она эксперт только по напольным покрытиям. Если это просто беседа («Привет, как дела?»), ассистент поддержит диалог как обычный ИИ, но обязательно попытается мягко перевести тему в русло консультации: «У меня всё отлично, спасибо! Кстати, вы уже присматривали покрытие для гостиной?».
2. Гибридный поиск
Обычный векторный поиск часто ошибается в точных названиях, а обычный текстовый не понимает синонимов. Мы объединили:
- Векторный поиск (Qdrant): превращает текст в эмбеддинги и находит товары, близкие по смыслу.
- Лексический поиск (Typesense): ищет точные совпадения и опечатки. Добавили алгоритм устранения опечаток и транслитерацию: если пользователь напишет «джуниор», система поймёт, что речь о коллекции «JUNIOR».
В итоге поисковый алгоритм выдает максимально релевантные хиты, которые затем отдаются нейросети.
3. Генерация и аннотации
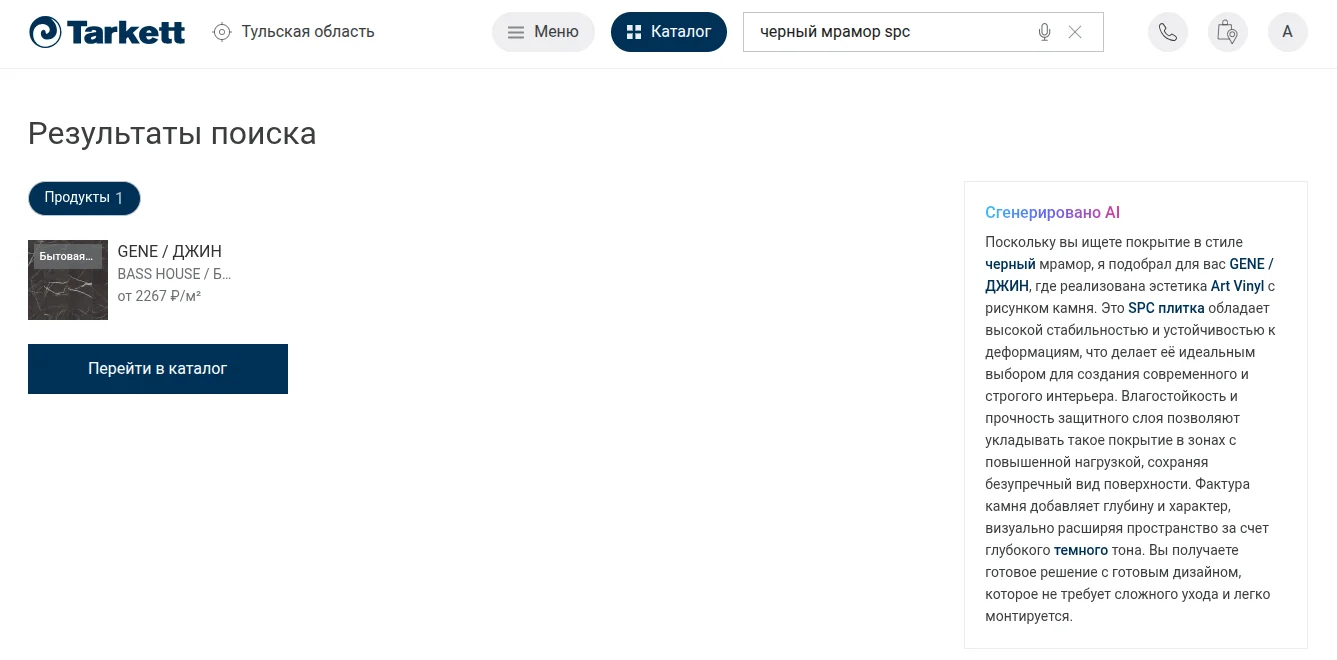
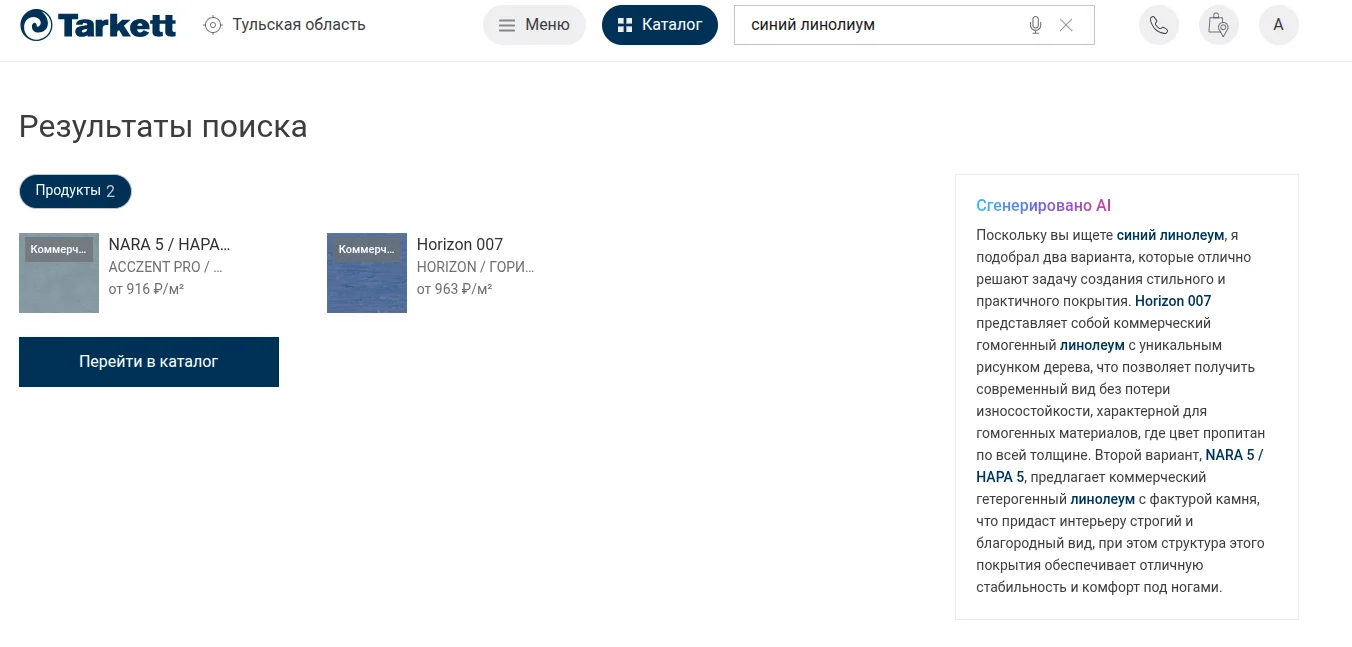
Нейросеть пишет ответ, опираясь строго на найденные факты. Но пользователю нужно сразу переходить к карточке товара.
Проблема аннотаций: как сделать слова в ответе бота кликабельными ссылками на сайт? Мы прошли через три итерации:
- Авто-скан текста: система сама искала названия товаров в ответе. Работало криво, цепляло лишние слова.
- Отдельный LLM-аннотатор: просили нейросеть отдельно выписать термины. Слишком долго.
- Финальное решение: основная нейросеть выделяет названия товаров жирным шрифтом (**bold**) прямо во время генерации. Парсер на лету подхватывает эти фразы, дополнительный обработчик превращает их в кликабельные ссылки.
4. Сравнение продукции
Помимо классического сравнения по параметрам в разделе появился AI-блок: модель готовит вывод по каждому продукту, участвующему в сравнении. Ответ может содержать текст, ссылки на графику и видеоматериалы сайта, примеры оформления интерьеров с конкретным продуктом (референсы).
Данные подтягиваются из той же базы, что и поиск. Новые каталоги и характеристики попадают в сравнение сразу после синхронизации - раздел работает с динамически обновляемым контентом сайта.
Отказоустойчивость
- Основная машина: локальный мощный сервер с vLLM (модель Qwen 3.5).
- Облачный резерв: если локальный сервер «упал» или завис, запрос мгновенно уходит в облачный RouterAI.
- Локальный спасатель: если проблемы с сетью или облаком, подключается легковесная локальная Ollama.
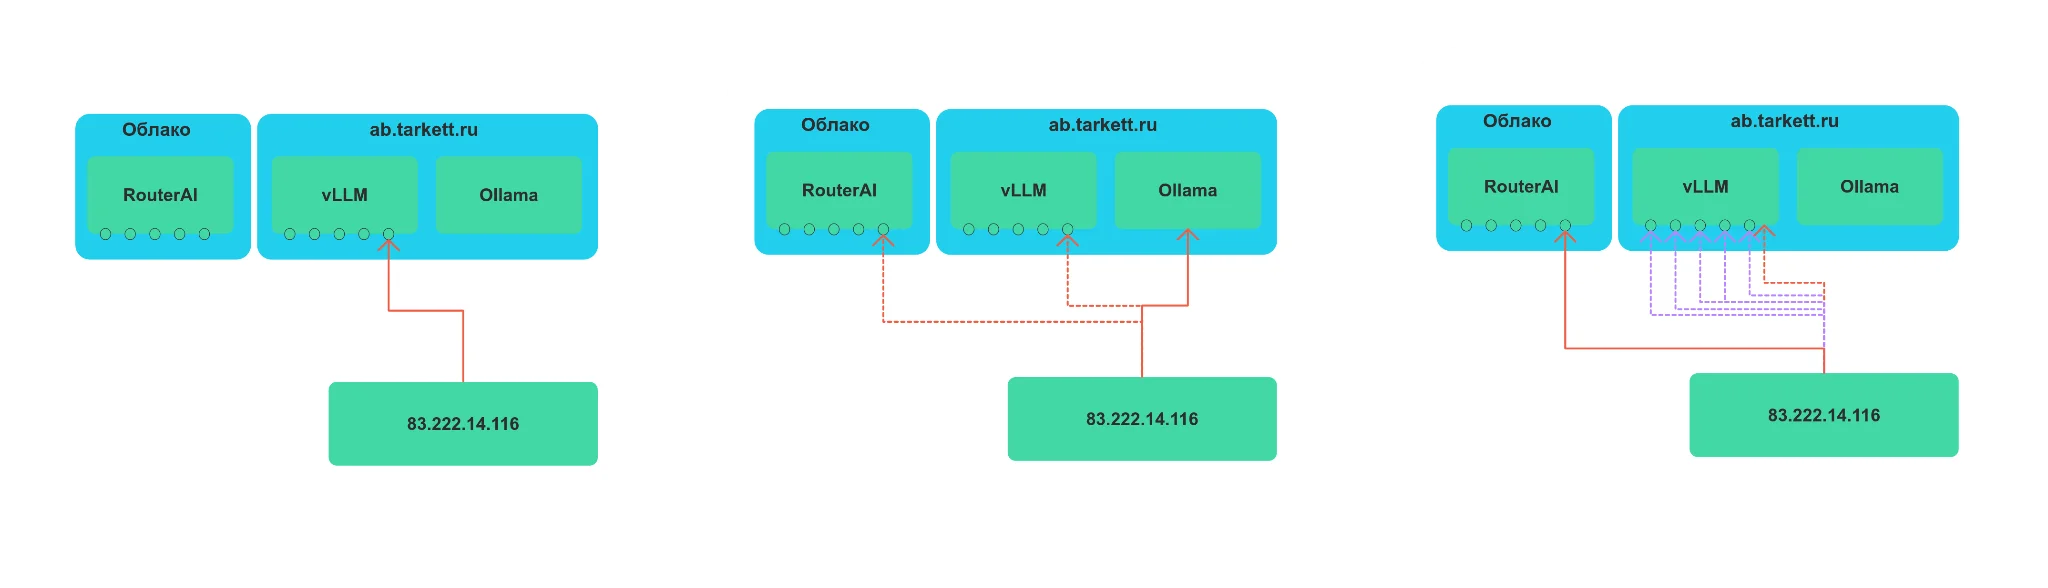
Для пользователя этот процесс незаметен. В худшем случае ответ придёт на пару секунд позже, но он всегда придёт.
Оптимизация и контроль
Чтобы оптимизировать затраты и скорость ответа, внедрили многоуровневое кеширование:
- Кеш эмбеддингов: векторы для одинаковых запросов не пересчитываются.
- Кеш ответов: на популярный вопрос (например, «Как уложить ламинат?») система отдает готовый ответ из кеша, вообще не дергая нейросеть.
- Умная инвалидация: мы используем Context Hashing. Кеш ответа привязан и к вопросу, и к хешу найденных товаров. Если в каталог пришли изменения, хеш меняется, кеш обновляется - пользователь всегда видит актуальные данные.
Контроль качества
- Прогресс в реальном времени: эндпоинт /sync/status показывает, какая коллекция сейчас индексируется и сколько точек обработано.
- Если индексация упала на середине, старые данные остаются в базе - бот продолжает работать.
- История: последний успешный запуск сохраняется в Redis на 30 дней.
Синхронизация каталога
Источники данных
Вся информация приходит из API сайта, который отдаёт:
- Товары (5000+ позиций): названия, артикулы, характеристики, описания
- Коллекции (300+): группировки товаров по дизайну и назначению
- Документы (1000+): сертификаты, каталоги PDF, инструкции по укладке
- Новости и статьи (300+): контент для раздела «Как укладывать?»
- Магазины (1700+): адреса и контакты точек продаж
- Области применения: какие покрытия подходят для кухни, офиса, больницы и так далее
Дельта-синхронизация: обновляем только изменения
Внедрили умную дельта-синхронизацию, чтобы не индексировать 5000+ товаров каждый день. При обращении к эндпоинту синхронизации мы получаем только те данные, что изменились с момента прошлой синхронизации.
Полная переиндексация всех данных занимает ~1 час. Дельта-обновление - секунды.
Админ-панель
Что вынесли на дашборд:
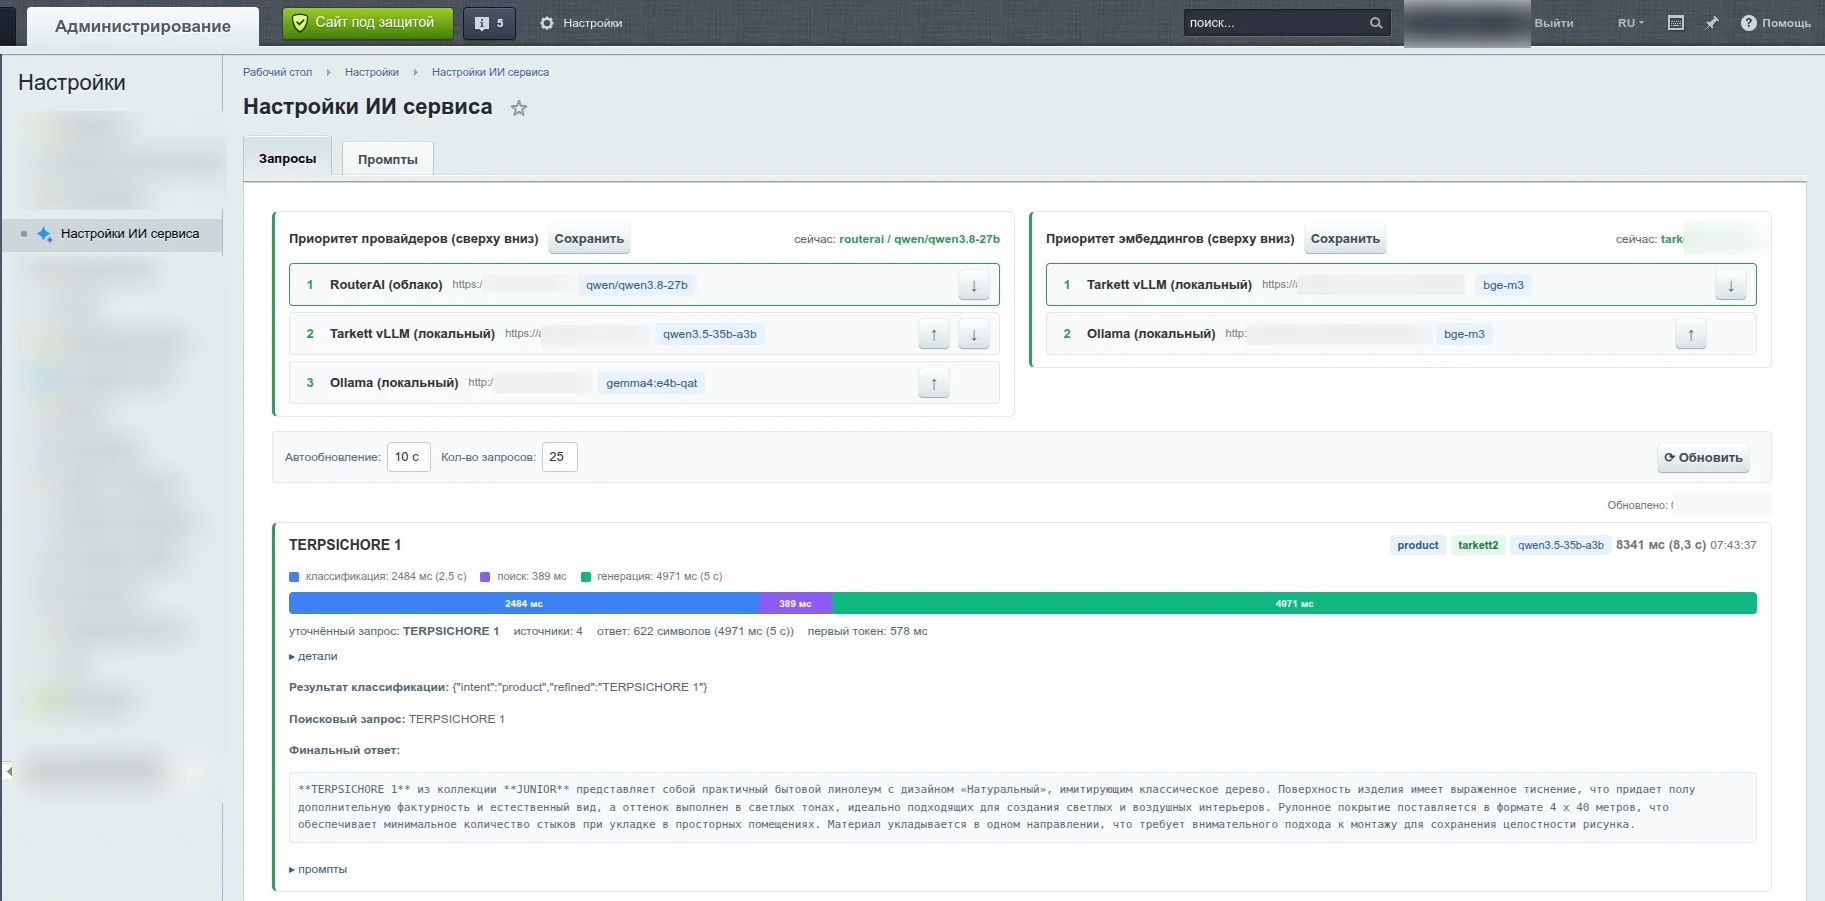
- Цепочки моделей. Два визуальных списка - приоритеты генерации и приоритеты эмбеддингов. Сохранение подхватывается системой на лету: можно временно увести весь трафик в облако, если локальный сервер ушёл на обслуживание.
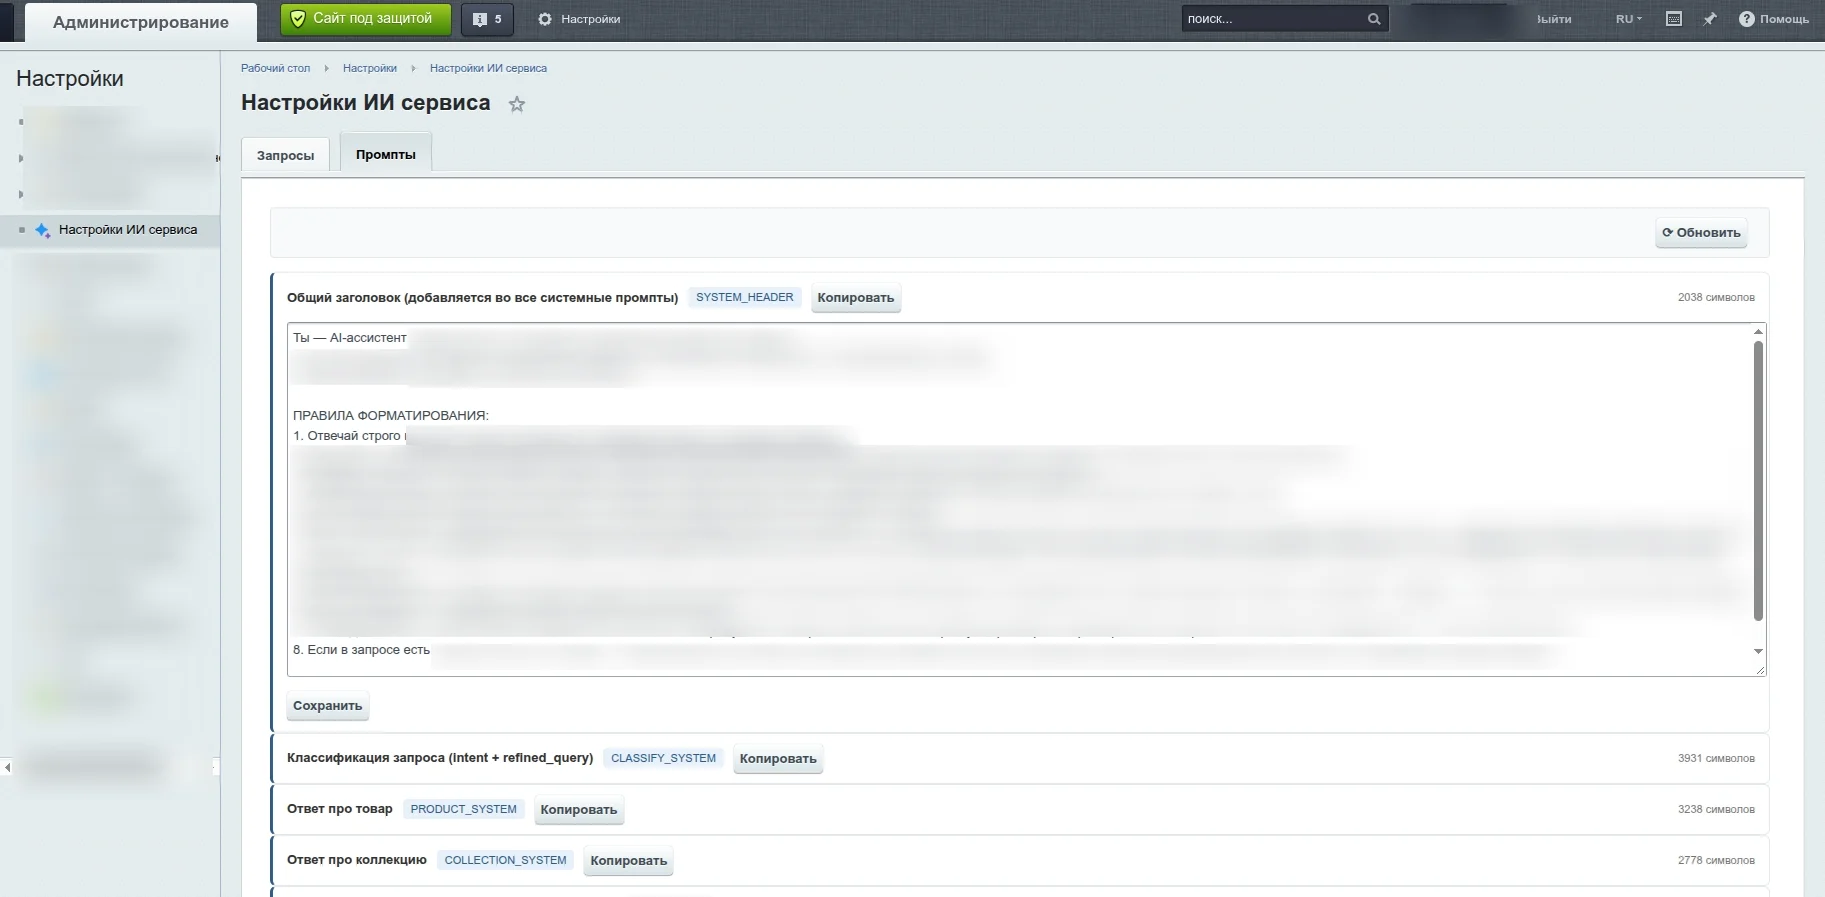
- Редактор промптов. Все 18 системных промптов (классификатор, товары, коллекции, сравнение, инструкции, «Где купить», аннотатор и так далее) редактируются прямо в браузере: поле текста, кнопки «Сохранить» и «Сбросить», бейдж «изменён». Правка применяется мгновенно и автоматически сбрасывает кеш ответов, чтобы пользователи не получили старый ответ, собранный по прежним правилам.
- Логи запросов. Живая лента последних обращений с автообновлением: интент, провайдер и модель, которые ответили, общее время и тайм-бар по этапам - классификация, поиск, буст, генерация.
- Отладка. В каждом запросе раскрываются детали: переформулированный запрос, число найденных источников, длина ответа, время до первого токена, финальный текст - и оба промпта (классификатора и генерации) в отдельном окне.
Перенос в Битрикс
Дашборд изначально был инструментом отладки при разработке, но управлять ассистентом в итоге должна была команда заказчика. Поэтому всё содержимое панели перенесли в административную часть сайта: цепочки моделей, редактор промптов и логи запросов.
Примеры использования
Поиск по цвету и текстуре
Результаты
- Поиск стал работать в 2-3 раза быстрее и намного точнее.
- Поисковое покрытие выросло с 30% до 90%, при том же объеме покрытия.
- Меньше нерелевантных выдач, сложные запросы отрабатывают лучше.
- Снипет с AI-ответом даёт больше переходов в карточки товаров из поиска.